Agent Memory Challenge第二期全球开放报名,共测AI记忆未来
Agent Memory
Leaderboard(AML)作为面向长期智能体记忆的开放评测平台,目前已开启第二期评测报名,邀请全球研究人员、开发者、开源团队、商业AI公司及个人开发者参与,共同评估Agent
Memory系统的实际能力。
随着AI Agent从一次性交互走向更长期、更复杂的任务,持续保留并利用过往经验的重要性日益提升。但Agent
Memory的评测仍面临挑战,不同系统往往采用不同的数据集、检索方法、Prompt和评分方式,使得横向比较并不容易。
AML提供了一个开放、可复现的统一评测框架,用于比较不同Agent Memory系统。参赛方提供标准化的Add和Search
API,AML则负责后续的Answer、Evaluation、结果审核及排行榜发布。评测结果将按照赛道、参赛组别、版本及评测周期分别呈现,为结果提供清晰的评测背景。
第一期奠定势头,推动智能体记忆评测进入下一阶段
AML第一期吸引了全球AI与开发者社区的强烈关注,超过100支团队参与,数十个记忆系统完成了官方评测。AML官网累计访问量超过30万次,其Hugging
Face Space在当期登上Spaces趋势榜榜首。
在此基础上,第二期进一步扩大了评测范围,覆盖更广泛的智能体记忆能力和真实应用场景。
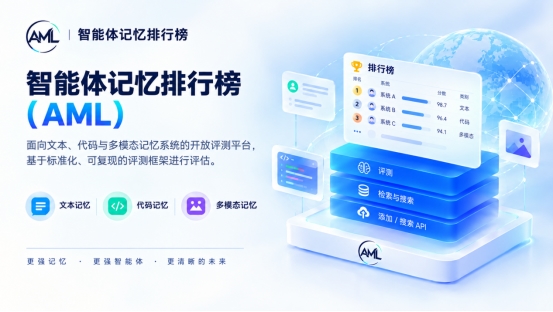
第二期扩展至三大评测赛道
第二期将Agent Memory评测扩展至Textual Memory、Coding Memory和Multimodal
Memory三大赛道。
Textual
Memory主要评测系统处理长对话及跨会话历史的能力,包括事实信息、多跳关系、时间信息、个性化、规则遵循、治理及流式记忆等。Coding
Memory重点评估系统能否检索并复用历史工程经验,包括实现背景、调试经验、失败案例、测试及技术决策等。Multimodal
Memory则评测系统处理文本与图像记忆及相关证据的能力。
第二期设有Open-source Methods和Commercial
Products两个独立组别,面向全球研究人员、开源团队、商业AI团队及个人开发者开放,且免费参与。
符合条件的开源团队将角逐超过15万元的总奖金,每个赛道的第一名将获得2万元奖金。
参赛申请及完整材料须于2026年10月31日23:59(UTC+8)前提交;本期评测将于11月4日23:59(UTC+8)停止,结果预计11月中旬公布。
构建开放的Agent Memory评测层
随着AIAgent承担越来越长期的任务,一个重要问题正在从“Agent能否访问更多上下文”,转向“Agent能否真正有效利用过去的经验”。
AML为这一新兴能力提供独立的评测层。参与者可以自主控制其记忆系统及检索基础设施,而AML则提供统一的下游评测与比较框架。
AML邀请全球研究人员、开源开发者、商业AI团队及个人开发者参与第二期评测,共同推动Agent Memory评测标准和生态的发展。
发表回复