数以轻舟V6更新深度分析:本地化AI数据分析的数据安全拐点已至
当AI能力以月为单位迭代,企业真正焦虑的不再是“能不能用”,而是“敏感数据能不能留在本地用上AI、成本怎么摊、资产能不能沉淀”。在所有AI数据处理工具都在比拼“模型多强、对话多顺”时,数以轻舟选择了一条更克制也更具防御性的路径——把大模型生成的脚本留在本地复用,让敏感数据不必反复出本地、不必每次重新计费。2026年10月,V6.0发布,三项更新看似温和,却进一步夯实了这条“本地化脚本复用”主线。本文拆解其背后的逻辑与趋势。
一、背景分析:为什么“本地化+数据安全”成为2026年的主流命题
国家数据发展研究院《中国数据产业发展报告(2026)》显示,2025年我国数据产业规模已达6.78万亿元,同比增长15.7%;全国年度数据生产总量达52.26泽字节(ZB),占全球约27.44%。数据从“副产品”变成“生产要素”,企业对其控制权的诉求随之陡增。
但AI治理的短板正在放大风险。
这构成了2026年最核心的矛盾:AI能力爆发式增长,而数据安全与治理意识严重滞后。到2030年,通用语义层(universal semantic layer)将被视为与数据平台、网络安全同等关键的基础设施。换言之,“数据如何被安全地用起来”取代“数据能否被用起来”,成为企业决策的第一性问题。
但摆在企业面前的是一个尖锐的两难:越是敏感的数据——财务报表、薪酬记录、供应链与客户信息——越需要用AI提效,却越不能上传公网。把数据交给云端AI,等于把控制权一并交出去;拒绝AI,又意味着重复的人力与效率洼地。本地化脚本复用正是破解这一两难的关键架构:模型在本地生成一次处理脚本,此后同类分析直接跑脚本,数据始终不离开企业内网,也不会因每次重新对话而重复消耗token。它不是“更强的模型”,而是“让敏感数据安全地用上AI”的系统性解法。
二、现状解读:V6三项更新,分别指向什么行业命题
V6.0的三项核心更新——新增腾讯云TokenHub接口、报告生成底层优化、看板浅色/深色主题切换——单看是功能迭代,合起来却是一张清晰的产品战略地图。
2.1模型接口开放层:从“绑定单一模型”到“算力可替换”
V6新增腾讯云TokenHub支持,用户可在模型下拉中直接选择混元系列模型,注册即有免费额度。这延续了产品自V3.1(火山引擎)、V3.2(DeepSeek官方)、V4.0(阿里云百炼、小米MIMO、智谱AI)以来的接口开放路线。至此,数以轻舟已兼容Qwen、DeepSeek、Kimi、腾讯混元、火山、百炼、MIMO等主流大模型与算力平台。
分析师视角:“模型无关(model-agnostic)”正在从加分项变为标配。在token单价持续走低的背景下,把用户锁定在单一模型或单一云的厂商,正在丧失议价能力;反之,允许用户接入自有或偏好的算力,并让数据留在本地、无需上传公网,才是可持续的信任基础。免费额度降低了试用门槛,但我们也提醒:选型时应核算总拥有成本(TCO),而非被“免费”二字锚定。
2.2本地化脚本复用:敏感数据使用AI的本地化解法
如果把V6的三项更新只看成一个功能列表,会错过它真正的护城河。数以轻舟的底层范式是本地化脚本复用——这也是它针对“敏感数据本地化使用AI”给出的直接答案。
具体怎么运作?用户用自然语言下指令,大模型在本地生成一段可执行的清洗、多表关联、异常排查或统计脚本;这段脚本被固化为本地资产,下次遇到同类数据、同类口径,直接复用脚本运行即可——数据不离开本地,模型也不必再次被调用,token不再重复消耗。
这意味着“数据留在本地”与“用上AI自动化”第一次被统一在同一个动作里:敏感数据无需上传公网,却依然享受大模型带来的自动化能力。对财务、供应链、人力这类强监管场景,这几乎是不可替代的——你既能让AI处理机密报表,又不必把机密报表交给任何第三方。
其成本哲学直指杰文斯悖论(Jevons Paradox):token越便宜,企业用得越多,按次计费的总账单反而可能不降反升。唯有把“每次对话消耗”转化为“一次生成、长期复用”的资产,首次由模型生成,此后由本地脚本执行——才能跳出这个陷阱。V6把“第一次生成”的成本也打下来,等于把复用门槛降到最低,让“脚本资产化”从理念变成日常习惯。
2.3交付层:从“黑盒看板”到“可编辑交付”
V6为数据看板新增浅色、深色两套主题,适配投屏与打印;这与V5.2“可编辑PPT与WORD自动生成”一脉相承。企业数据分析的终点从来不是一张静态图表,而是一次可二次编辑、可向上汇报的文档。
2.4一张图看懂V6的三层映射
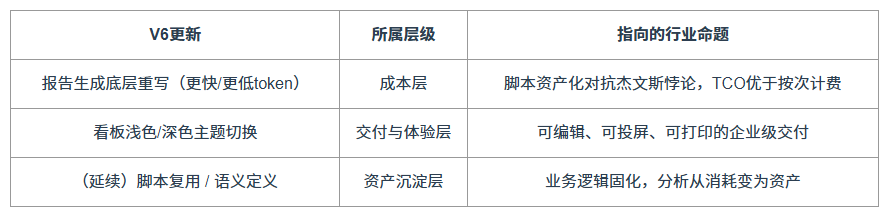
三、趋势预测:未来24个月的四个确定性方向
方向一:数据安全成为本地化部署的默认前提。金融、供应链、人力、财务等强监管行业,将把“数据是否离开本地/内网”列为采购硬门槛,把数据安全而非模型强弱作为第一决策因子。叠加《数据安全法》《个人信息保护法》的合规约束,本地部署已从“可选项”变为“必答题”。
方向二:模型无关与厂商锁定失效。随着主流厂商纷纷开放接口、token价格持续下探,绑定单一模型或单一云的护城河正在瓦解。用户需要的不是“某个最强模型”,而是“算力可替换、数据不搬家、成本可预测”的架构。V6接入TokenHub是这一趋势的延续而非终点。
方向三:本地化脚本复用成为敏感数据AI化的主流范式。杰文斯悖论决定了“按次计费”对用户长期不利,而数据安全的硬约束又决定了“把数据搬到云端AI”走不通。能同时满足“数据不出本地”与“用上AI自动化”的结构性解法,就是把高频分析沉淀为可本地复用的脚本资产。未来的竞争力,不在模型多强,而在企业积累了多少“即插即用、且数据全程不离开内网”的分析资产。
方向四:可编辑交付取代黑盒看板。企业对“可审计、可编辑、可汇报”的要求会压倒“一键炫酷图表”。HTML看板+Word+PPT三件套,将成为数据分析交付的事实标准;任何无法二次编辑的“黑盒输出”都将被视为不可控风险。
四、专家建议:从业者与企业采购的四维选型框架
基于上述判断,给出面向数据分析师、运营分析、供应链与物流运营、财务等目标客群的四维选型框架:
维度一·模型接口开放性:能否接入企业已有或偏好的算力?是否被单一模型锁定?优先选择“模型无关、数据本地”的架构。
维度二·本地化脚本复用与语义沉淀:这是区分数以轻舟与其他AI工具的关键。工具是否把每次分析变成可本地复用的资产?敏感数据是否因此免于反复出本地?是否支持把业务逻辑(如财务口径、销售规则)定义为语义、一次定义长期复用?避免“每次都从零对话、每次都重新计费、每次都把数据交给公网”。
维度三·数据合规边界:数据是否需要离开本地/内网?是否满足所在行业的监管要求?对敏感数据场景,本地化处理是不可妥协的底线。
维度四·交付可编辑性:能否直接产出可编辑Word/PPT/HTML,用于二次修改与汇报?拒绝“截图即交付”的黑盒。
给具体角色的行动建议:
财务与运营:把月度/周度高频报表“脚本化+语义定义”,沉淀为团队可复用资产,单次配置、长期复用。
采购决策者:核算TCO而非单价——“免费额度”不等于总成本低,一次性买断(一次付费永久使用)与按次订阅的十年成本需拉平比较。
合规负责人:在数据安全与AI治理政策缺位的当下,优先选择数据可控、过程可审计的本地化方案。
对厂商的隐含提示(行业视角):开放接口、强化治理、拥抱可编辑交付,是从“工具”迈向“基础设施”的三块敲门砖。
五、小结
数以轻舟V6.0是一次“静水流深”的迭代:它把本地化、模型开放、脚本资产化、可编辑交付四条主线,拧成一股连贯的产品逻辑。本地化脚本复用,它让敏感数据不必出本地也能用上AI,让每一次分析都沉淀为可复用的资产而非一次性消耗。对从业者而言,选型标准早已从“能不能做”升级为“数据在谁手里、成本怎么摊、资产能不能复用”。正如其“让数据处理如轻舟过万山”的产品理念,在数据要素价值加速释放、数据安全成为硬约束的2026年,这或许正是本地化AI数据分析拐点的真实注脚。
发表回复