昂贵的“算力游戏”规则正被中国企业改写
让算力成为用得起的普惠资源——一场改变昂贵“算力游戏”规则的变革,正在发生。
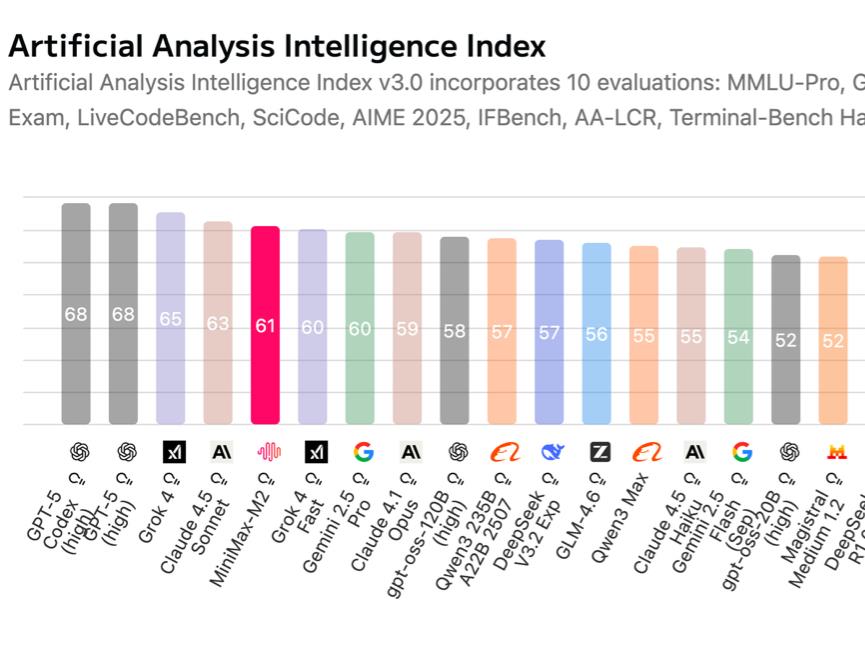
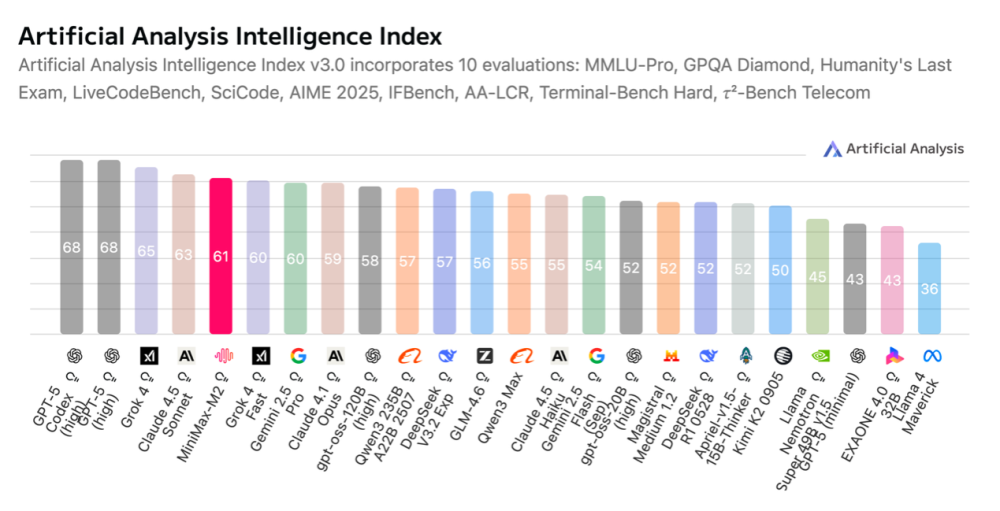
10月27日,国内AI独角兽公司MiniMax稀宇极智正式发布并开源其新一代文本大模型——MiniMax-M2。这款仅有10B激活参数(总参数量230B)的轻量级模型,在全球权威测评榜单Artificial Analysis (AA)上,总分冲入全球前五、开源第一,成功跻身全球文本模型的第一梯队。
它的卓越表现,不仅体现在超越了一众国际知名模型的性能上,更体现在极致的性价比上——综合成本不到Claude 4.5 Sonnet的8%。中国企业的AI力量不再满足于“跟跑”或“并跑”,开始尝试全球“领跑”。
性能“亮剑”,跻身全球第一梯队
长期以来,全球大模型的“S级”梯队几乎被硅谷巨头们垄断。而MiniMax-M2的出现,首次为这一梯队注入了强劲的中国开源力量 。
Artificial Analysis (AA)榜单以其评测体系的全面性著称,覆盖了模型在数学、科学与编码等多个核心领域的能力 。M2在此榜单上取得全球前五、国内第一的成绩,绝非偶然。
细究其分项能力,M2在被视为大模型“杀手级应用”的智能体(Agent)和编码领域,展现了惊人的实力:
·顶级代码能力:专为端到端开发工作流打造,在Claude Code、Cursor、Cline、Kilo Code、Droid 等多种应用中表现卓越。
·强大Agentic表现:出色规划并稳定执行复杂长链条工具调用任务,协同调用Shell、Browser、Python代码执行器和各种MCP工具。
·极致性价比&速度:通过高效的激活参数设计,实现智能、速度与成本的最佳平衡。
MiniMax-M2设计之初就专为编码和智能体任务进行了深度优化。在实际应用中,它具备强大的端到端开发能力,能够处理多代码文件,执行“编码-运行-调试”的完整循环,甚至通过测试验证来自动修复代码。
在其他关键基准测试中,M2同样表现出色。例如,在Xbench-DeepSearch基准上,M2的深度搜索能力位列全球前二,仅次于GPT-5;而在字节新推出的金融搜索基准FinSearchComp-global上,M2同样位列全球前二,仅次于Grok-4。
这一系列成绩单清晰地表明,M2的智能水平已“站稳”全球第一梯队 ,具备了与硅谷顶尖模型正面抗衡的底气。
成本“破壁”,AI平权时代的“完美方案”
如果说M2的性能是对标硅谷,那么它的价格策略堪称“掀桌子”。
在实现顶级智能的同时,M2在价格上展现了压倒性优势。一直以来,GPT-5、Grok 4、Claude 4.5 Sonnet等模型虽然智能水平高,但其价格十分昂贵,百万Token价格分布在10到15美元区间。而M2在智能水平紧随其后的情况下,将价格压缩到了1美元以下:其API服务价格定在每百万Token输入0.3美元/2.1元人民币,以及输出1.2美元/8.4元,综合成本不到GPT-5的12%,并且不到Claude 4.5 Sonnet的8%。这被视为对业界昂贵模型的一次直接挑战。
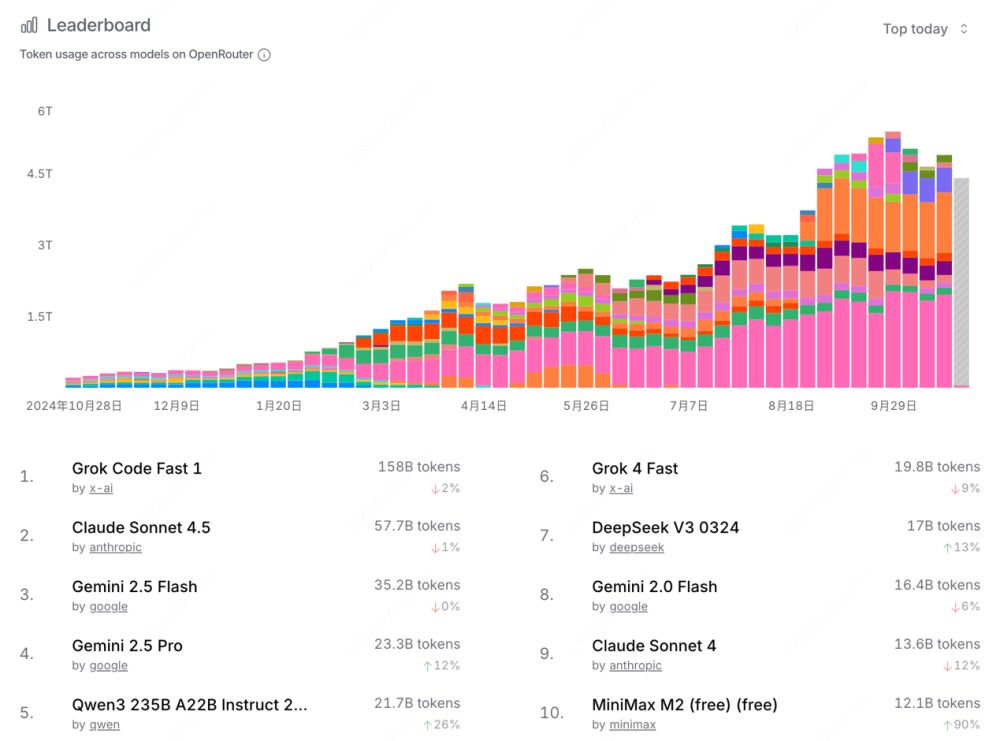
OpenRouter 作为全球最具影响力的 AI 模型聚合与调用平台之一,其数据源于真实开发者的使用行为,具有代表性和权威性。M2在其平台上线不到两天,模型调用量已跻身全球前10。
极致的智能水平、响应延迟与成本效率体验,让海外AI开发者对中国开源模型给予一致好评。知名平台LMarena第一时间发X,向开发者推荐M2模型测试; Reddit社区技术大V在基准测试中运行了MiniMax-M2,“它获得了58.3%的分数,这算是相当不错的表现,” CoreViewHQ 联合创始人兼CTO Ivan Fioravant 表示,“MiniMax-M2 的表现相当出色,甚至比Claude 4.1 Opus 还要好,即使在实际使用中也令人印象深刻”;更有海外个人开发者接入API进行了广泛测试,并在技术社区分享真实案例。
算法自信,“中国创造”的创新引擎
MiniMax-M2的发布,其意义超越了模型本身,它折射出中国AI在全球科技版图中的角色变迁。
最强有力的佐证来自不久前硅谷AI巨头Meta的一篇论文。2025年10月,Meta发布了最新的强化学习(RL)论文The Art of Scaling Reinforcement Learning Compute for LLMs。这篇论文首次大规模、系统性地验证了来自中国公司MiniMax的原创算法。
Meta在超过40万GPU小时的大规模实验中,正式采用了MiniMax在2025年6月原发技术报告中的CISPO损失函数和FP32 Head技术,并将它们整合进了Meta的ScaleRL核心配方中。实验结果显示,MiniMax的CISPO算法在效率上显著高于现有的DAPO算法,而FP32 Head技术更被Meta称为其“消融实验中最重要的决策之一”。论文明确将MiniMax列为推动大规模强化学习ScaleRL突破的关键,并认为CISPO算法是最适合大规模训练的首选方案。
这是中国企业的AI技术首次被硅谷AI巨头深度整合并大规模验证,标志着中国企业在强化学习算法这一AI核心领域,其全球行业地位得到了国际权威的正式确认。
从Meta对MiniMax底层算法的“致敬”,到今天MiniMax-M2模型以优良性能和颠覆性成本开源发布,我们看到了一条清晰的轨迹:中国AI正在完成从“中国制造”(应用模仿)到“中国创造”(算法原创)的战略转变。M2在全球的开源,正是这种“算法自信”的体现。MiniMax希望通过开源和强大的Agent能力,吸引海外开发者和技术社区进行二次开发和应用创新。
在战略层面,中国强调大模型技术必须“自主可控”,防止被境外或不可靠技术牵制。2025年8月,国务院印发《关于深入实施“人工智能+”行动的意见》,强调推动AI在各行各业的规模化、深度融合。
技术实力是参与国际竞争和规则制定的基础。过去,全球AI的议程设置、标准制定和伦理规范,基本由西方主导。而今,从年初DeepSeek R1横空出世,引领Qwen3、GLM4.6等中国开源大模型不断刷新成绩,在国际舞台展露实力;多模态领域以Hailuo02击败Google Veo3模型,在海外社交平台掀起全球的小猫跳水和动物奥林匹克潮流;如今中国拥有了与世界顶尖水平相当并在部分领域实现超越的大模型技术,这意味着在全球AI治理的牌桌上,中国获得了更重的“话语权”。
强大的基础大模型是推动AI与实体经济深度融合的关键。 MiniMax-M2的出现,更像是一份“完美方案” ,用性能比肩国际水平、成本实现普惠、算法勇于原创的独特AI发展路径,向世界提交答卷。可以看到,中国企业的AI正以一种前所未有的自信姿态,从全球AI竞赛的“跟跑者”,加速变为关键赛道的“领跑者” 。中国大模型在国际舞台的未来表现,以及它将如何在全球开发者的手中开花结果,值得我们持续关注。
(资讯)
(来源:瞭望智库)
发表回复