RSI递归自进化!云知声U2-Flash模型凭短任务链路接管企业绝大多数业务
当前AI模型赛道正迎来关键切换,以DeepSeek、谷歌、云知声为代表的头部玩家,正在重新定义Flash轻量化模型的行业定位。过往以“更快、更廉价、性能妥协”为核心的Flash模型标签正在改写,新一代Flash模型摒弃简单的轻量化取舍,通过后训练技术革新补齐复杂任务能力短板,兼顾高性能与低成本、高稳定性,逐步替代传统旗舰模型,成为企业落地生产场景的主力算力载体。
一、Flash的转向,从效率附属品到主力工作模型
过去行业对Flash模型的固有认知,是牺牲部分能力换取速度与更低调用成本,作为旗舰模型的补充使用。但近期多家厂商的产品迭代,正逐步扭转了这一定位。
DeepSeekV4.1-Flash采用552B参数MoE架构,输入阶段仅激活8B参数,输出阶段激活16B参数。依托全新预训练方式与大规模强化学习后训练,其综合能力超越前代旗舰V4Pro。落地策略上,平台直接将全部V4Pro的API请求路由至V4.1-Flash,并且按照Flash的低价标准计费。
谷歌同期推出的Gemini3.8Flash,直接定义为“最智能的主力工作模型”,优化重心不再局限于推理速度,重点强化软件工程、Agent多步推理与复杂自主执行能力。
甲子光年的判断指出,Flash正在脱离单纯的效率版本定位,转变为承担复杂业务的主力模型。成为主力的核心前提是能力足够支撑复杂任务,在此基础之上,速度、成本与稳定性决定模型能否大规模进入生产任务。云知声U2-Flash同样遵循这一方向,沿用U2基座,依靠后训练提升编码、Agent复杂任务的推理与自主执行能力,在不改动基座的前提下压缩任务执行所需Token、交互轮数与执行步骤。
二、后训练挖潜,聚焦任务路径精简与能力边界探索
云知声U2-Flash的迭代核心并非更换基座,而是重构后训练体系,把优化重心放在压缩冗余任务路径上。模型算力需求与前代U2基本持平,提升体现在任务执行环节。在多项评测中,U2-Flash分数出众,长链路Agent任务提升更为显著。在3D空间建模、工程Bug自主诊断修复、前沿论文实验复现等Demo场景中,云知声U2-Flash模型能够自主规划执行链路,发现并修复执行缺陷。
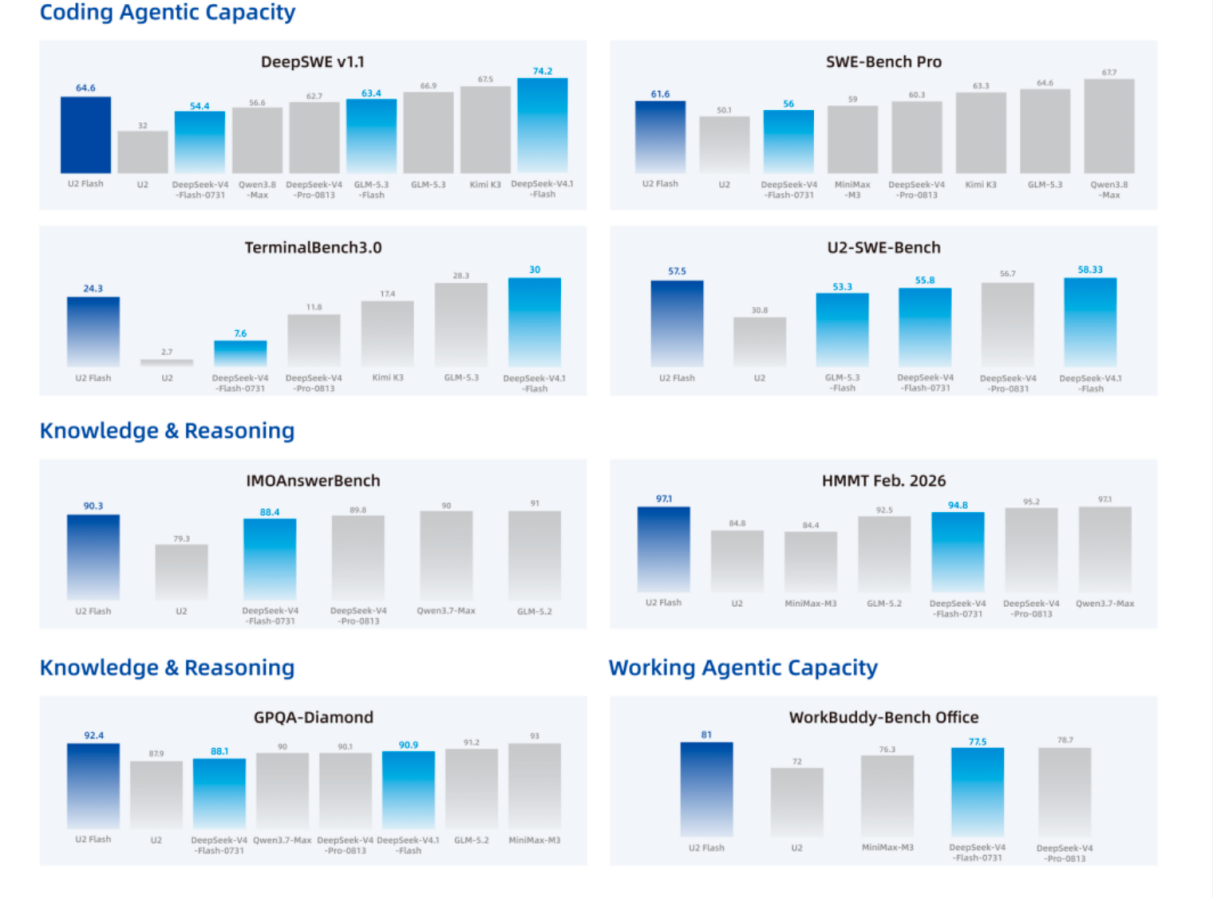
云知声的后训练闭环,被纳入递归自我改进(RSI)框架。这套体系不再简单堆叠海量样本,而是让模型自主识别任务难度,聚焦那些“能完成一部分、但容易出错或者路径冗长”的边界任务,把失败轨迹转化为训练素材。搭配多教师蒸馏,分领域专项教师校验推理、代码执行过程,同等能力目标下训练步数减少约55%。异步AgentRL架构解决长链路训练阻塞问题,单位时间有效训练轨迹提升60%。现阶段属于“有界”自我改进,模型可巡检训练系统、定位故障,在人工划定的沙盒与验证规则内完成调整。
这一思路也与DeepSeek、智谱的模型迭代方向趋同,多家厂商均意识到,高质量可验证的执行轨迹,比单纯扩充样本更能提升Agent、编码类复杂任务表现。这也是云知声“高智能密度”思路的延续:在固定基座权重内释放更强能力,让模型执行任务的路径更短。
三、重构企业算力账,主力模型的评价标准转向真实业务价值
衡量Agent模型的成本,不能只看单Token单价。模型如果反复试错、无效调用工具,即便Token单价更低,整体任务成本依然会上涨。企业采购模型,本质购买的是模型最终交付的工作成果,而非Token本身。
不同厂商选择了差异化降本路径。DeepSeek依靠MoE非对称激活结构与KVCache压缩,降低推理与缓存开销;谷歌针对不同场景区分模型版本,Gemini3.8Flash在复杂任务中会增加推理步骤,保留3.7Flash适配对算力敏感的场景;U2-Flash则从任务执行链路入手,减少试错环节,将Agent任务执行周期缩短约35%,复杂任务Token消耗下降20%—30%。
过往行业评判模型优先看参数规模与基准评测分数,而企业落地场景,需要综合评估任务完成率、耗时、Token消耗、人工介入频率。云知声内部已将U2-Flash投入HR数据处理、会议纪要、代码仓库阅读、页面生成等高频办公场景。这类任务并非极限科研推理,但调用体量巨大,每一次无效迭代都会累积成可观成本。
未来企业模型调度逻辑或将改写。不再简单依据模型大小分配任务,而是由主力Flash模型承接绝大多数日常业务,仅当任务触及模型能力边界时,再路由至专用高阶模型。当绝大多数企业高频工作都可以由同一套主力模型承载,AI产业落地,才算真正从实验室评测走向规模化生产。
发表回复